Husnul Amalia
Bagaimana AI Belajar Mengenal Proses Training AI
WWW.GOLANEDUCATION.COM – Bagaimana AI belajar hingga mampu mengenali gambar, memahami bahasa manusia, memberikan rekomendasi, dan menjawab pertanyaan dengan cepat? Kemampuan tersebut tidak muncul secara otomatis, melainkan terbentuk melalui proses pelatihan yang melibatkan data, algoritma, komputasi, dan evaluasi. Proses ini dikenal sebagai training AI atau pelatihan kecerdasan buatan, yaitu tahapan ketika sistem mengolah contoh untuk mempelajari pola yang dapat digunakan dalam menyelesaikan tugas tertentu.
Di tengah perkembangan teknologi digital, pemahaman mengenai cara kerja kecerdasan buatan semakin penting bagi pelajar, mahasiswa, pendidik, dan masyarakat umum. AI kini digunakan dalam berbagai bidang, mulai dari pendidikan, kesehatan, industri, hingga layanan pelanggan. Dengan memahami proses pembelajarannya, masyarakat dapat mengetahui alasan AI mampu menghasilkan prediksi dan jawaban, sekaligus memahami keterbatasan teknologi tersebut.
Meskipun AI dapat menghasilkan keluaran yang terlihat cerdas, cara kerjanya tidak sepenuhnya sama dengan proses belajar manusia. Sistem AI mempelajari hubungan dalam data melalui metode komputasi, kemudian menggunakan pola tersebut untuk menghasilkan prediksi atau keluaran berdasarkan masukan yang diterima. Oleh karena itu, mengenal proses training AI membantu pengguna memanfaatkan teknologi secara lebih kritis, bertanggung jawab, dan sesuai kebutuhan.
Mengenal Training AI
Training AI merupakan proses melatih model kecerdasan buatan agar mampu mengenali pola, memahami hubungan antarvariabel, dan menghasilkan keluaran berdasarkan data yang diberikan selama pelatihan. Dalam proses ini, pengembang menentukan tujuan pembelajaran, memilih metode yang sesuai, lalu menggunakan algoritma untuk menyesuaikan parameter model. Hasilnya adalah sistem yang dapat menjalankan tugas tertentu tanpa harus menerima instruksi terperinci untuk setiap kemungkinan masukan.
Sebagai contoh, sistem AI yang dirancang untuk mengenali kucing dan anjing membutuhkan banyak contoh gambar dari kedua kategori tersebut. Setiap gambar mengandung informasi visual, seperti bentuk telinga, tekstur bulu, ukuran tubuh, dan karakteristik lainnya. Melalui pelatihan, model mempelajari hubungan statistik dalam data tersebut sehingga dapat memperkirakan kategori gambar baru yang belum pernah dilihatnya.
Kendati demikian, training AI tidak berarti mesin memiliki kesadaran atau memahami dunia seperti manusia. Model mempelajari pola berdasarkan struktur data dan metode matematis yang digunakan. Kemampuannya sangat dipengaruhi oleh kualitas contoh, rancangan algoritma, serta tujuan pelatihan, sehingga hasil yang terlihat meyakinkan belum tentu selalu benar. Pemahaman ini penting agar pengguna tidak menganggap setiap keluaran AI sebagai fakta yang pasti.
Data sebagai Bahan Belajar
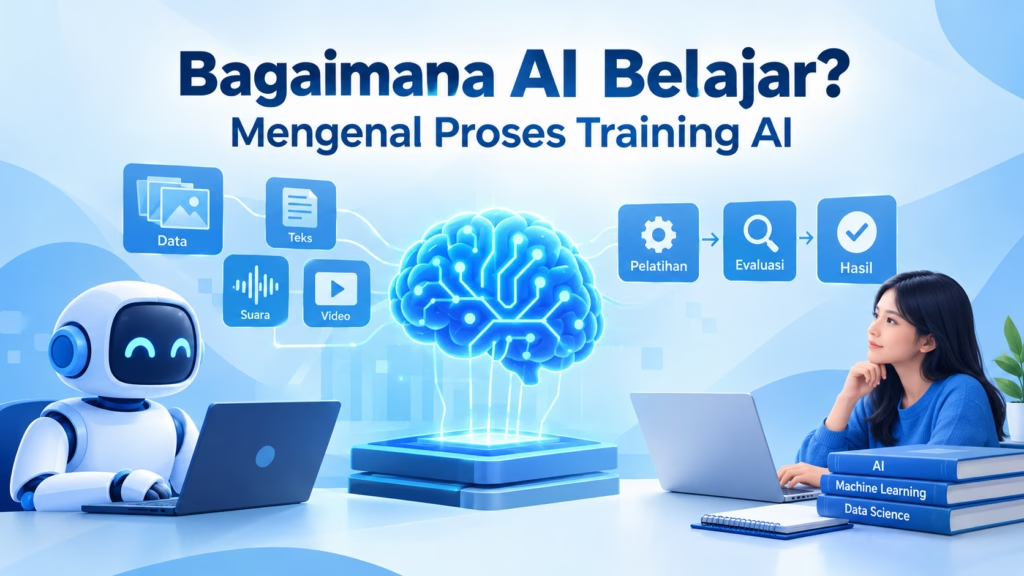
Data merupakan salah satu komponen terpenting dalam proses pembelajaran AI karena menjadi sumber informasi yang digunakan model untuk menemukan pola. Bentuknya beragam, mulai dari teks, gambar, rekaman suara, video, hingga angka yang berasal dari transaksi atau sensor. Jenis data dipilih berdasarkan tugas yang ingin diselesaikan, sebab model pengenal wajah membutuhkan karakteristik data berbeda dari sistem yang memprediksi permintaan pasar.
Sebelum digunakan, data umumnya melewati tahap pengumpulan, pemeriksaan, pembersihan, dan pengorganisasian. Data yang duplikat, tidak relevan, salah label, atau mengandung informasi yang tidak konsisten dapat mengganggu proses pelatihan. Oleh sebab itu, pengembang perlu memastikan bahwa data memiliki kualitas yang memadai dan penggunaannya sesuai dengan ketentuan privasi serta hak yang berlaku. Langkah tersebut membantu mengurangi kesalahan yang mungkin terbawa hingga model diterapkan.
Komposisi data juga menentukan sejauh mana model mampu bekerja pada berbagai situasi. Apabila sistem dilatih menggunakan gambar dengan pencahayaan terang saja, misalnya, performanya mungkin menurun ketika menghadapi gambar dalam kondisi gelap. Masalah serupa dapat muncul ketika data tidak mewakili kelompok pengguna atau kondisi nyata yang akan dihadapi. Dengan demikian, keberagaman dan keterwakilan data menjadi pertimbangan penting untuk menghasilkan model AI yang lebih andal.
Tahapan Pelatihan Model
Proses training AI biasanya dimulai dengan menentukan masalah yang hendak diselesaikan, kemudian memilih model dan menyiapkan data yang relevan. Pengembang perlu menetapkan apakah sistem akan mengklasifikasikan objek, memprediksi angka, mengenali ucapan, atau menghasilkan teks. Tujuan tersebut memengaruhi pemilihan algoritma, ukuran model, kebutuhan komputasi, serta cara keberhasilannya diukur. Perencanaan yang tepat membantu proses pelatihan berjalan lebih terarah.
Pada tahap pelatihan, data dimasukkan ke dalam model agar sistem menghasilkan prediksi. Prediksi tersebut dibandingkan dengan target atau dinilai menggunakan mekanisme pembelajaran yang sesuai, lalu dihitung besarnya kesalahan melalui fungsi loss. Dalam banyak metode pembelajaran mesin, algoritma optimasi menggunakan informasi kesalahan untuk memperbarui parameter model. Siklus ini dilakukan berulang kali sehingga model secara bertahap menyesuaikan pola internalnya untuk menghasilkan prediksi yang lebih baik.
Proses tersebut membutuhkan pemantauan karena pelatihan yang berlangsung terlalu singkat dapat membuat model belum mempelajari pola secara memadai, sedangkan pelatihan yang berlebihan berisiko menyebabkan overfitting. Kondisi ini terjadi ketika model terlalu menyesuaikan diri dengan data latihan sehingga kesulitan menghadapi contoh baru. Untuk mengendalikannya, pengembang memantau performa pada data validasi, menyesuaikan konfigurasi pelatihan, dan memilih model yang memberikan keseimbangan antara ketepatan serta kemampuan generalisasi.
Jenis Pembelajaran AI
Salah satu pendekatan yang umum digunakan adalah supervised learning atau pembelajaran terawasi. Metode ini menggunakan data yang disertai label atau jawaban acuan sehingga model dapat membandingkan prediksi dengan target yang diharapkan. Contohnya adalah sistem penyaring pesan spam yang dilatih menggunakan kumpulan pesan berlabel spam dan bukan spam. Dari contoh tersebut, model mempelajari pola yang membantu menentukan kategori pesan baru, meskipun hasilnya tetap dapat keliru.
Pendekatan berikutnya ialah unsupervised learning atau pembelajaran tanpa pengawasan, yaitu metode yang mencari struktur atau pola dalam data tanpa mengandalkan label target seperti pada pembelajaran terawasi. Salah satu penerapannya adalah pengelompokan pelanggan berdasarkan kemiripan perilaku transaksi. Hasil pengelompokan dapat membantu perusahaan memahami karakteristik konsumennya, sedangkan interpretasi terhadap kelompok tersebut tetap memerlukan analisis manusia agar tidak menghasilkan kesimpulan yang menyesatkan.
Metode lain adalah reinforcement learning atau pembelajaran penguatan, ketika agen mempelajari strategi melalui interaksi dengan lingkungan dan menerima imbalan atau penalti berdasarkan tindakannya. Pendekatan ini dapat digunakan dalam simulasi robotika, pengendalian sistem, dan pengembangan strategi permainan. Pada praktiknya, ketiga pendekatan tersebut memiliki tujuan serta mekanisme berbeda, sehingga pemilihannya perlu disesuaikan dengan jenis masalah, ketersediaan data, dan hasil yang ingin dicapai.
Peran Algoritma AI
Algoritma berperan sebagai metode matematis yang mengatur bagaimana model mempelajari informasi dari data. Algoritma menentukan cara model memproses masukan, menghitung kesalahan, dan memperbarui parameter selama pelatihan. Dalam pembelajaran mesin, metode seperti regresi linear, pohon keputusan, dan jaringan saraf tiruan digunakan untuk menyelesaikan jenis permasalahan yang berbeda. Pemilihan algoritma tidak hanya bergantung pada tingkat akurasi, tetapi juga mempertimbangkan kebutuhan komputasi, kecepatan pemrosesan, serta kemudahan interpretasi hasil.
Jaringan saraf tiruan menjadi salah satu pendekatan penting dalam perkembangan AI modern karena mampu mempelajari hubungan kompleks dalam data. Model ini terdiri atas lapisan-lapisan komputasi yang memproses informasi secara bertahap. Dalam deep learning, jaringan dengan banyak lapisan dapat mempelajari representasi data yang semakin kompleks, misalnya dari karakteristik visual sederhana hingga bentuk objek yang lebih utuh. Namun, model yang lebih besar biasanya membutuhkan sumber daya komputasi dan data pelatihan yang lebih besar pula.
Pada sistem AI generatif, termasuk model bahasa, pelatihan dapat melibatkan proses mempelajari pola bahasa dari kumpulan teks yang sangat besar. Model mempelajari keterkaitan antarkata dan konteks untuk memperkirakan token berikutnya, kemudian dapat disesuaikan melalui tahapan tambahan agar lebih sesuai dengan kebutuhan pengguna. Mekanisme tersebut memungkinkan AI menghasilkan tulisan yang tampak alami, tetapi tidak menjamin bahwa setiap informasi yang disampaikan akurat. Oleh karena itu, hasil AI tetap perlu diperiksa, terutama ketika berkaitan dengan fakta, keputusan penting, atau informasi yang sensitif.
Evaluasi Hasil Training
Setelah proses pelatihan selesai, model perlu dievaluasi untuk mengetahui kemampuannya dalam menghadapi data yang belum digunakan selama pembelajaran. Data umumnya dibagi menjadi data pelatihan, data validasi, dan data pengujian dengan fungsi berbeda. Data pelatihan digunakan untuk mempelajari pola, data validasi membantu menentukan konfigurasi model, sedangkan data pengujian digunakan untuk menilai performa akhir secara lebih objektif. Pemisahan ini penting agar hasil evaluasi tidak sekadar mencerminkan kemampuan model mengingat contoh latihan.
Metrik evaluasi ditentukan berdasarkan jenis tugas yang dikerjakan. Dalam klasifikasi, misalnya, pengembang dapat menggunakan akurasi, presisi, recall, dan skor F1 untuk melihat aspek performa yang berbeda. Sementara itu, tugas prediksi angka dapat dinilai menggunakan metrik seperti mean absolute error atau root mean squared error. Penggunaan metrik yang tepat membantu menjelaskan apakah model benar-benar memenuhi kebutuhan, sebab nilai akurasi yang tinggi belum tentu menggambarkan seluruh risiko kesalahan.
Evaluasi yang baik juga perlu mempertimbangkan potensi bias, keamanan, dan perubahan kondisi penggunaan. Model yang bekerja baik pada data pengujian belum tentu mempertahankan performanya ketika diterapkan pada lingkungan yang berbeda. Karena itu, pengembang perlu melakukan pengujian tambahan, memeriksa kesalahan yang berulang, dan memantau performa setelah sistem digunakan. Pendekatan tersebut membantu mengidentifikasi masalah lebih awal serta menjadi dasar untuk memperbaiki model secara terukur.
Penerapan AI Sehari-hari
Dalam bidang pendidikan, AI dapat membantu menyediakan latihan yang disesuaikan dengan kebutuhan siswa, memberikan umpan balik awal, dan mendukung pencarian informasi. Sistem pembelajaran adaptif, misalnya, dapat menggunakan pola jawaban untuk memperkirakan materi yang perlu dipelajari kembali. Meskipun demikian, teknologi tersebut sebaiknya digunakan sebagai pendukung proses belajar, bukan pengganti peran pendidik. Guru dan dosen tetap dibutuhkan untuk membimbing pemahaman, menilai perkembangan siswa, serta membangun kemampuan berpikir kritis.
Pada sektor bisnis, training AI memungkinkan perusahaan mengembangkan sistem rekomendasi produk, mendeteksi transaksi mencurigakan, dan memperkirakan kebutuhan persediaan. Model mempelajari pola dari data historis, kemudian menggunakan pola tersebut untuk menghasilkan prediksi yang mendukung pengambilan keputusan. Kendati demikian, kondisi pasar dapat berubah akibat tren, kebijakan, atau perilaku konsumen, sehingga hasil prediksi perlu dipertimbangkan bersama informasi terbaru dan penilaian profesional.
Dalam kehidupan sehari-hari, penerapan AI dapat ditemukan pada pengenalan wajah, asisten virtual, penerjemah otomatis, dan penyaringan surat elektronik. Kemampuan tersebut merupakan hasil pengembangan model yang dirancang untuk tugas tertentu, bukan bukti bahwa satu model dapat memahami semua persoalan secara sempurna. Pengguna perlu memperhatikan perlindungan data pribadi, memeriksa informasi yang dihasilkan, dan menghindari memasukkan informasi rahasia ke layanan yang belum dipahami kebijakan privasinya. Dengan cara tersebut, manfaat AI dapat digunakan secara lebih aman dan bertanggung jawab.
Tantangan dan Masa Depan AI
Salah satu tantangan utama dalam training AI adalah kebutuhan terhadap data berkualitas dan sumber daya komputasi yang memadai. Pelatihan model berskala besar dapat membutuhkan perangkat keras khusus, energi, waktu, serta biaya pengembangan yang tidak sedikit. Bagi organisasi dengan anggaran terbatas, pemanfaatan model yang sudah tersedia, penggunaan data yang lebih terarah, atau penerapan model berukuran lebih kecil dapat menjadi pilihan yang lebih realistis. Strategi terbaik bergantung pada kebutuhan, risiko, dan kemampuan teknis masing-masing organisasi.
Tantangan lain berkaitan dengan bias data, privasi, keamanan, serta potensi keluaran yang keliru. Model dapat mewarisi ketimpangan dalam data pelatihan atau menghasilkan jawaban yang terdengar meyakinkan meskipun tidak didukung fakta. Oleh sebab itu, pengembangan AI perlu melibatkan pengujian yang memadai, tata kelola data, pengawasan manusia, dan penjelasan mengenai keterbatasan sistem. Dalam konteks pendidikan maupun bisnis, pengguna juga perlu memahami bahwa tanggung jawab atas keputusan penting tidak dapat sepenuhnya dialihkan kepada mesin.
Ke depan, perkembangan AI diperkirakan terus mendorong perubahan dalam cara manusia belajar, bekerja, dan mengelola informasi. Kemajuan model multimodal, metode pelatihan yang lebih efisien, serta peningkatan kemampuan evaluasi membuka peluang penerapan yang semakin luas. Namun, kemajuan tersebut perlu diimbangi dengan literasi digital agar masyarakat mampu membedakan kemampuan nyata AI dari klaim yang berlebihan. Memahami bagaimana AI belajar menjadi langkah awal untuk mengikuti perkembangan teknologi sekaligus menentukan kapan teknologi tersebut layak digunakan.